Quadratic programming
이번 글에서는 지난 글부터 다루고 있는 여러 type of optimization problem들을 계속해서 알아보는 것의 일환으로, 다항적 체계의 관점에서 선형 계획법의 연장선이라고 간주되는 Quadrtic programming에 대해 알아본다.
A quadratic program, 줄여서 QP는 다음과 같은 형태의 최적화 문제이다.
여기서 는 optimization variable이고, 는 문제를 정의하는 데이터이다.
목적함수는
로 주어진다. 첫 번째 항 는 quadratic term이고, 두 번째 항 는 linear term이다. 제약조건은 처럼 linear inequality로 주어진다.
따라서 QP는 간단히 말해
를 가지는 최적화 문제이다.
또한 QP가 convex하려면
이어야 한다. 즉, 가 positive semidefinite이어야 한다.
이번 글에서는 QP를 실제로 푸는 방법은 다루지 않는다. 대신 다음 세 가지 예시가 어떻게 QP의 일반형으로 표현되는지만 확인한다.
1. Example: portfolio optimization
첫 번째 예시는 portfolio optimization이다.
투자자가 개의 자산에 돈을 나누어 투자한다고 하자. 이때 를 번째 자산에 투자하는 비율이라고 하자. 그러면 전체 투자 비율의 합은 1이어야 하므로
이다. 또한 short selling을 허용하지 않는다면
이어야 한다.
각 자산의 기대수익률을 모은 벡터를 라고 하고, 자산 수익률의 covariance matrix를 라고 하자. 그러면 포트폴리오의 기대수익률은
이고, 포트폴리오의 위험은
로 나타낼 수 있다.
따라서 포트폴리오 최적화 문제는 다음과 같이 쓸 수 있다.
여기서 는 위험을 얼마나 싫어하는지를 나타내는 parameter이다.
목적함수는
의 형태이다.
QP는 보통 minimize 형태로 쓰기 때문에 위 문제를 minimize 문제로 바꾸면
이 된다.
1.1 Numerical example
세 개의 자산이 있다고 하자.
즉, 세 자산의 기대수익률은 각각 이다. 공분산 행렬의 대각성분은 각 자산의 variance를 나타내므로, 이 예시에서는 세 번째 자산이 가장 위험한 자산이다.
이때 문제는
이다.
이제 이 문제가 QP의 일반형
에 어떻게 들어가는지 확인하자.
먼저 optimization variable을
라고 둔다.
목적함수의 quadratic term은 이다. QP 일반형에서는 quadratic term이 이므로,
가 되어야 한다. 따라서
이다.
즉,
linear term은 이므로
이제 제약조건을 형태로 쓰자.
제약조건 은 두 개의 inequality로 쓸 수 있다.
또한 도 linear inequality이다.
따라서
결국 이 portfolio optimization 문제는
꼴로 쓸 수 있으므로 QP이다.
2. Example: support vector machine
두 번째 예시는 support vector machine, 줄여서 SVM이다.
SVM은 Data classification 문제에서 자주 등장한다. 데이터가 , 으로 주어졌다고 하자. 여기서 는 feature vector이고,
이다.
즉, 각 데이터는 두 class 중 하나에 속한다. 이면 positive class, 이면 negative class라고 생각할 수 있다.
2.1 Linear classifier and decision boundary
선형 SVM에서는 다음과 같은 함수를 사용한다.
여기서 는 weight vector이고, 는 bias term이다.
SVM은 의 부호를 보고 class를 분류한다.
이면 class로 분류하고,
이면 class로 분류한다.
따라서 두 class를 나누는 경계는
이다.
이 경계를 decision boundary라고 한다.
예를 들어 2-dimensional data라면 decision boundary는 직선이고, 더 높은 차원에서는 hyperplane이 된다.
2.2 Margin boundary
SVM은 단순히 데이터를 올바르게 나누는 decision boundary만 찾는 것이 아니다.
SVM은 decision boundary와 데이터 사이의 간격을 가능한 크게 만들고 싶어한다. 이 간격을 margin이라고 한다.
이를 위해 SVM에서는 decision boundary 양옆에 두 개의 margin boundary를 생각한다.
즉, SVM에서는 다음 세 개의 평행한 hyperplane을 생각할 수 있다.
가운데에 있는
이 실제 decision boundary이고, 양옆의 두 hyperplane
이 margin boundary이다.
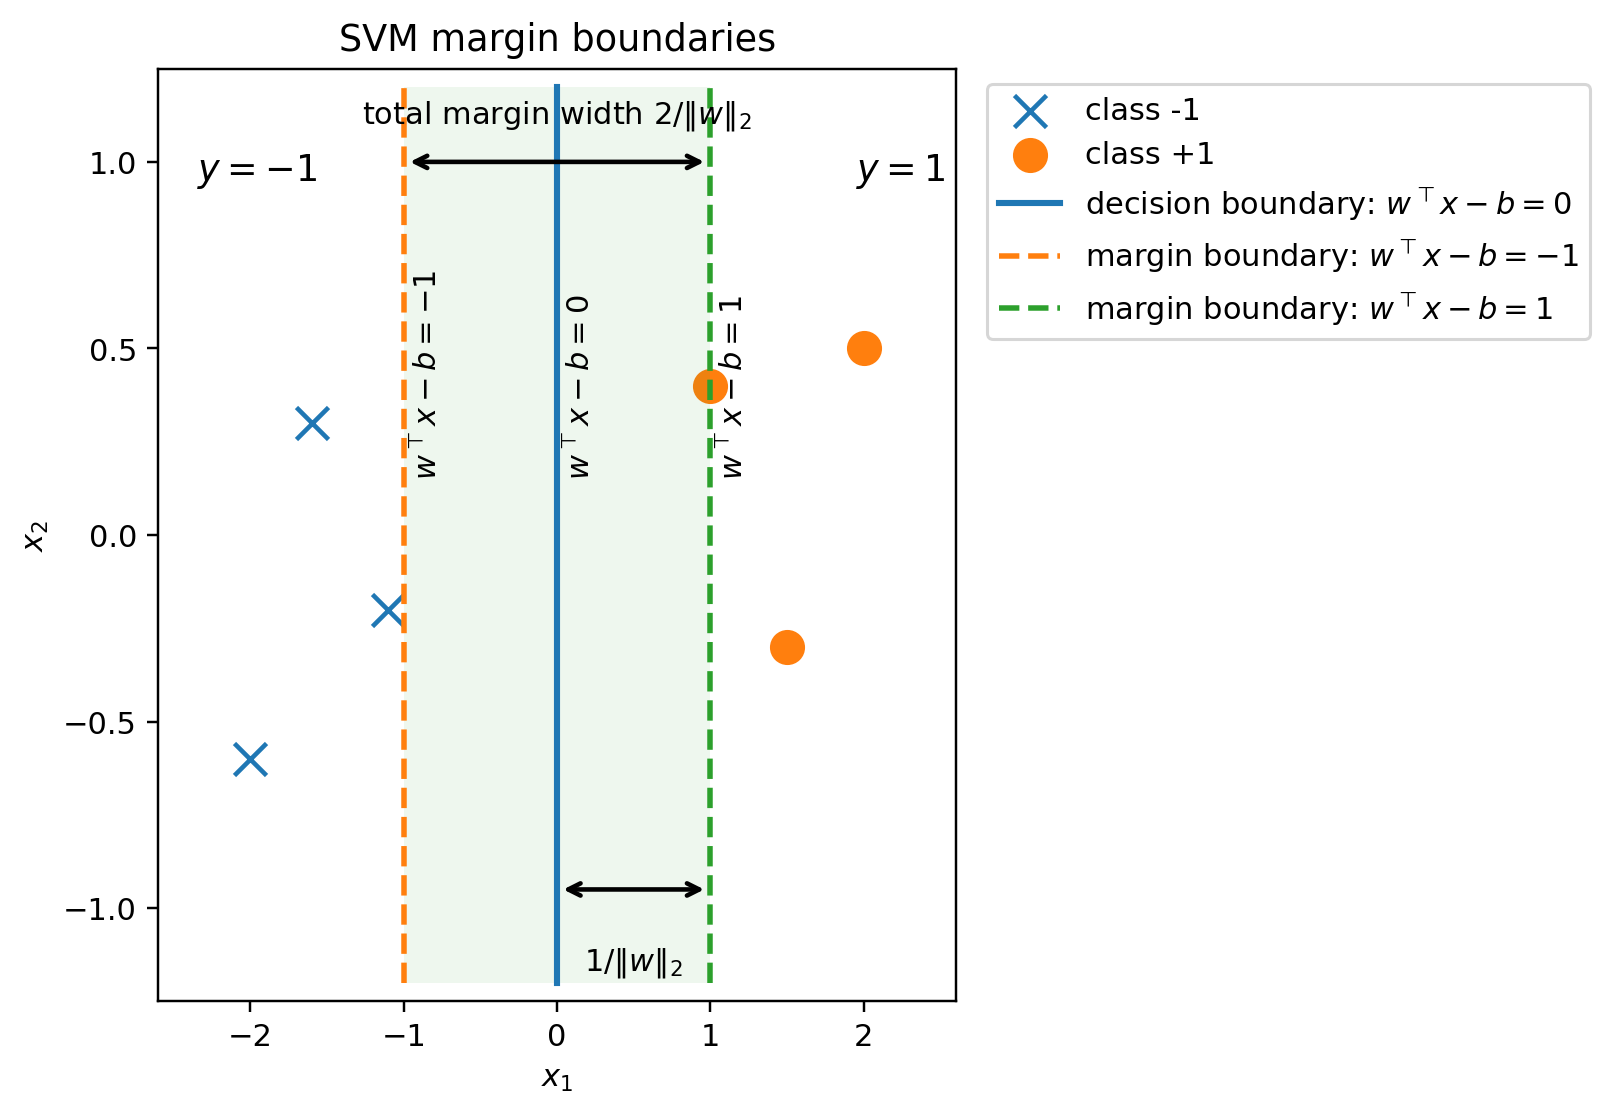
이상적인 경우, class의 데이터는 오른쪽 margin boundary 바깥에 있어야 한다. 즉,
을 만족해야 한다.
반대로 class의 데이터는 왼쪽 margin boundary 바깥에 있어야 한다. 즉,
을 만족해야 한다.
이 두 조건은 하나의 식으로 합칠 수 있다.
왜 그런지 확인해보자.
먼저 이면,
은
이 된다.
즉, positive class의 데이터가 오른쪽 margin boundary 바깥에 있다는 뜻이다.
반대로 이면,
은
이므로
이 된다.
즉, negative class의 데이터가 왼쪽 margin boundary 바깥에 있다는 뜻이다.
따라서 조건
은 각 데이터가 자기 class 쪽 margin boundary 바깥에 있기를 요구하는 조건이다.
2.3 Why does SVM minimize ?
이제 margin의 폭을 생각해보자.
일반적으로 두 평행한 hyperplane
과
사이의 거리는
이다.
SVM의 decision boundary는
이고, 오른쪽 margin boundary는
이다.
이 둘 사이의 거리는
이다.
마찬가지로 decision boundary와 왼쪽 margin boundary
사이의 거리도
이다.
따라서 두 margin boundary 사이의 전체 폭은
이다.
SVM은 margin을 크게 만들고 싶다. 즉,
를 크게 만들고 싶다.
이는 곧
를 작게 만드는 것과 같다.
그래서 SVM의 목적함수에는
라는 term이 들어간다.
여기서 는 margin을 크게 만드는 것을 얼마나 중요하게 볼 것인지 조절하는 parameter이다.
정리하면,
따라서 SVM은 를 작게 만드는 방향으로 classifier를 찾는다.
2.4 Soft-margin SVM
지금까지의 설명은 모든 데이터가 margin boundary 바깥에 잘 놓여 있다고 가정한 것이다.
즉, 모든 데이터가
을 만족한다고 생각했다.
하지만 실제 데이터에서는 이런 조건을 완벽하게 만족하기 어려울 수 있다. 데이터에 noise가 있거나, 두 class가 완전히 분리되지 않을 수도 있다.
그래서 soft-margin SVM은 margin 조건을 어느 정도 위반하는 것을 허용한다. 대신 위반한 만큼 penalty를 준다.
각 데이터의 margin은
이다.
만약
이면 margin 조건을 만족하므로 penalty가 없다.
반대로
이면 margin이 부족하다. 부족한 정도는
이다.
따라서 하나의 데이터에 대한 penalty를 다음과 같이 정의한다.
이것이 hinge loss이다.
margin이 1 이상이면 hinge loss는 0이다. 이미 충분히 잘 분류되었기 때문이다.
반대로 margin이 1보다 작으면 hinge loss는 양수가 된다. 즉, margin을 충분히 확보하지 못한 만큼 penalty가 생긴다.
결국 soft-margin SVM은 다음 두 가지를 동시에 고려한다.
첫째, margin을 크게 만들기 위해 를 작게 만든다.
둘째, margin 조건을 위반한 데이터에 대해서는 hinge loss로 penalty를 준다.
따라서 soft-margin SVM은 다음 optimization problem으로 표현된다.
첫 번째 항
은 large margin을 만들기 위한 regularization term이다.
두 번째 항
은 margin violation에 대한 평균 penalty이다.
2.5 SVM as QP
이제 위 SVM 문제가 왜 QP인지 보자.
soft-margin SVM은
이다.
이 식은 max가 들어 있기 때문에 바로 QP 일반형처럼 보이지 않는다. 이를 QP로 바꾸기 위해 auxiliary variable 을 도입한다.
각 가 번째 데이터의 hinge loss를 대신한다고 생각하자. 즉,
가 되도록 만들면 된다.
이 조건은 다음 두 조건과 같다.
따라서 SVM은 다음과 같이 쓸 수 있다.
첫 번째 제약조건을 정리하면
이다.
따라서 SVM은
가 된다.
목적함수에는 라는 quadratic term이 있고, 제약조건은 모두 에 대한 linear inequality이다.
따라서 SVM은 QP이다.
2.6 Numerical example
간단하게 1-dimensional data 5개를 보자.
모델은
이고, 이라고 하자.
그러면 SVM 문제는
이다.
auxiliary variable 를 도입하면
각 데이터에 대해 제약조건을 쓰면 다음과 같다.
첫 번째 데이터는 이므로
두 번째 데이터는 이므로
세 번째 데이터는 이므로
네 번째 데이터는 이므로
다섯 번째 데이터는 이므로
따라서 QP는
이제 이 문제를 QP 일반형의 로 직접 써보자.
optimization variable은
이다.
목적함수는
이다.
QP 일반형의 목적함수
와 비교하면, 이차항은 에만 존재한다.
따라서
이어야 하므로
이다.
나머지 변수에 대한 quadratic term은 없으므로
linear term은
이므로
이제 제약조건을 형태로 정리한다.
는
이고,
는
이다.
또한
는
이고,
는
이다.
마지막으로
는
이다.
여기에 을 추가하면,
따라서 이 SVM 예시는
꼴로 정확히 표현된다.
3. Example: LASSO
세 번째 예시는 LASSO이다.
LASSO는 regression 문제에서 자주 사용된다. 기본적인 least squares 문제는
이다.
여기서 는 data matrix이고, 는 response vector이다. 는 우리가 찾고 싶은 regression coefficient vector이다.
least squares는 prediction error를 줄이는 방향으로 를 선택한다. 즉,
를 작게 만드는 를 찾는다.
LASSO는 여기에 -penalty를 추가한다.
여기서
이다.
즉, LASSO는 다음 두 가지를 동시에 고려한다.
첫 번째 항은 data를 잘 설명하게 만들고, 두 번째 항은 coefficient들의 크기가 너무 커지지 않도록 막는다.
3.1 Why L1 penalty?
LASSO의 핵심은 -penalty이다.
이므로, 이 항은 coefficient들의 절댓값 합을 작게 만들려고 한다.
가 클수록 coefficient들은 더 강하게 0 쪽으로 밀린다. 특히 -penalty는 어떤 coefficient를 정확히 0으로 만드는 효과가 있다. 그래서 LASSO는 feature selection에 사용된다.
예를 들어 이 되면, 번째 feature는 예측에 사용되지 않는 것과 같다. 따라서 LASSO는 regression을 하면서 동시에 중요한 feature만 남기는 역할을 할 수 있다.
다만 이 글의 목적은 LASSO를 푸는 것이 아니라, LASSO가 QP 형태로 바뀐다는 것을 확인하는 것이다.
3.2 LASSO as QP
LASSO가 QP처럼 바로 보이지 않는 이유는 absolute value가 들어 있기 때문이다.
는 그대로는 quadratic function도 아니고 linear function도 아니다. 하지만 auxiliary variable을 도입하면 absolute value를 linear constraint로 표현할 수 있다.
새로운 변수 를 도입해서
가 되도록 하자.
이 조건은 다음 두 조건과 같다.
따라서 에 등장하는 absolute value는 선형제약으로 표현할 수 있다.
즉,
를 직접 다루는 대신, auxiliary variable 를 도입하고 목적함수에
를 넣으면 된다.
이제 LASSO는 다음과 같이 쓸 수 있다.
여기서 least squares term 은 에 대한 quadratic function이고, 제약조건은 모두 linear inequality이다. 따라서 LASSO는 QP이다.
3.3 Numerical example
두 개의 feature가 있는 regression 문제를 보자.
그러면 LASSO 문제는
이다.
먼저
이므로
따라서
이를 전개하면
이고,
이다. 따라서
양변에 를 곱하면
상수항 는 최적해의 위치에 영향을 주지 않으므로 QP 형태를 확인할 때는 생략해도 된다.
따라서 LASSO는 다음 문제와 같은 형태이다.
이제 absolute value를 없애기 위해 auxiliary variable 를 도입한다.
가 되도록 하면 된다. 이는 각각
그리고
와 같다.
따라서 LASSO는 다음 QP로 바뀐다.
이제 이를 로 쓰자.
optimization variable은
이다.
목적함수
를
와 비교하면
이고,
제약조건은
이다. 이를 형태로 쓰면
따라서
따라서 이 LASSO 문제도
꼴로 표현된다.